精选精读 / 021 / 科技与未来

千脑智能Thousand Minds · 英文原书名,中译《千脑智能》:把智能从「算得多快」改写成「有多少个模型在投票」

[美]杰夫·霍金斯 著

大脑不是一台计算机,
是十五万个模型在同时投票。

龙哥短评

这本书最值钱的地方,是它敢给一个统一解释。神经科学里到处是这块管这块、那块管那块的碎片,很少有人敢说所有区域其实在做同一件事;敢把这句话写成可以被实验打脸的形式,本身就值得尊敬,哪怕最后被证伪。我自己的判断是:它给的不是结论,是一套重新提问的工具——为什么分区只是表面的?为什么知识非长在动作里不可?为什么模型会主动过滤反证?这三问带回去,比记住任何一个术语都管用。 但有一处保留,我得指到具体地方:全书的核心机制是「投票」。这十五万个模型怎么达成一致,霍金斯用了一个社会过程的词,却没给票数、权重、程序,也没说平票怎么办。波普尔那一刀正切在这里——如果投票理论错了,我们会看到什么?他答不上来。而「投票统一了」等于说「它们统一了」,统一本身才是要解释的东西,他只是把问题往后推了一步。另一处是第三部分关于把人类知识备份到太空的讨论,跟前面的神经科学只隔着一层薄薄的连接,更像两篇插进来的随笔。我的态度是:按假说读,别按结论引。 落到我自己身上,是三条。第一,我判断自己懂没懂,不再问能不能复述,只问能不能从任意一点在心里走到另一点——走不通,就是模型缺角。第二,我给自己的每个判断加一行反证条件:写清楚「如果我是错的,应该看到什么」,然后去找它;找不到不等于我对,只代表还没找到。第三,明知该做却做不到的,我不改决心,我改环境——手机放到另一个房间,比对自己说一百遍今晚早睡有效。带娃也一样:不动手,就别指望真懂。这三条你现在就能试。

浙江教育出版社(湛庐)· 2022 年 9 月第 1 版 · 廖璐、熊宇轩、马雷 合译 · 313 页 · ISBN 978-7-5722-4184-0;另有台湾星出版 2023 年繁体版《千脑智能新理论》(许瑞宋译,352 页),两版书名、章次与页码不同,请按手上的版本核对

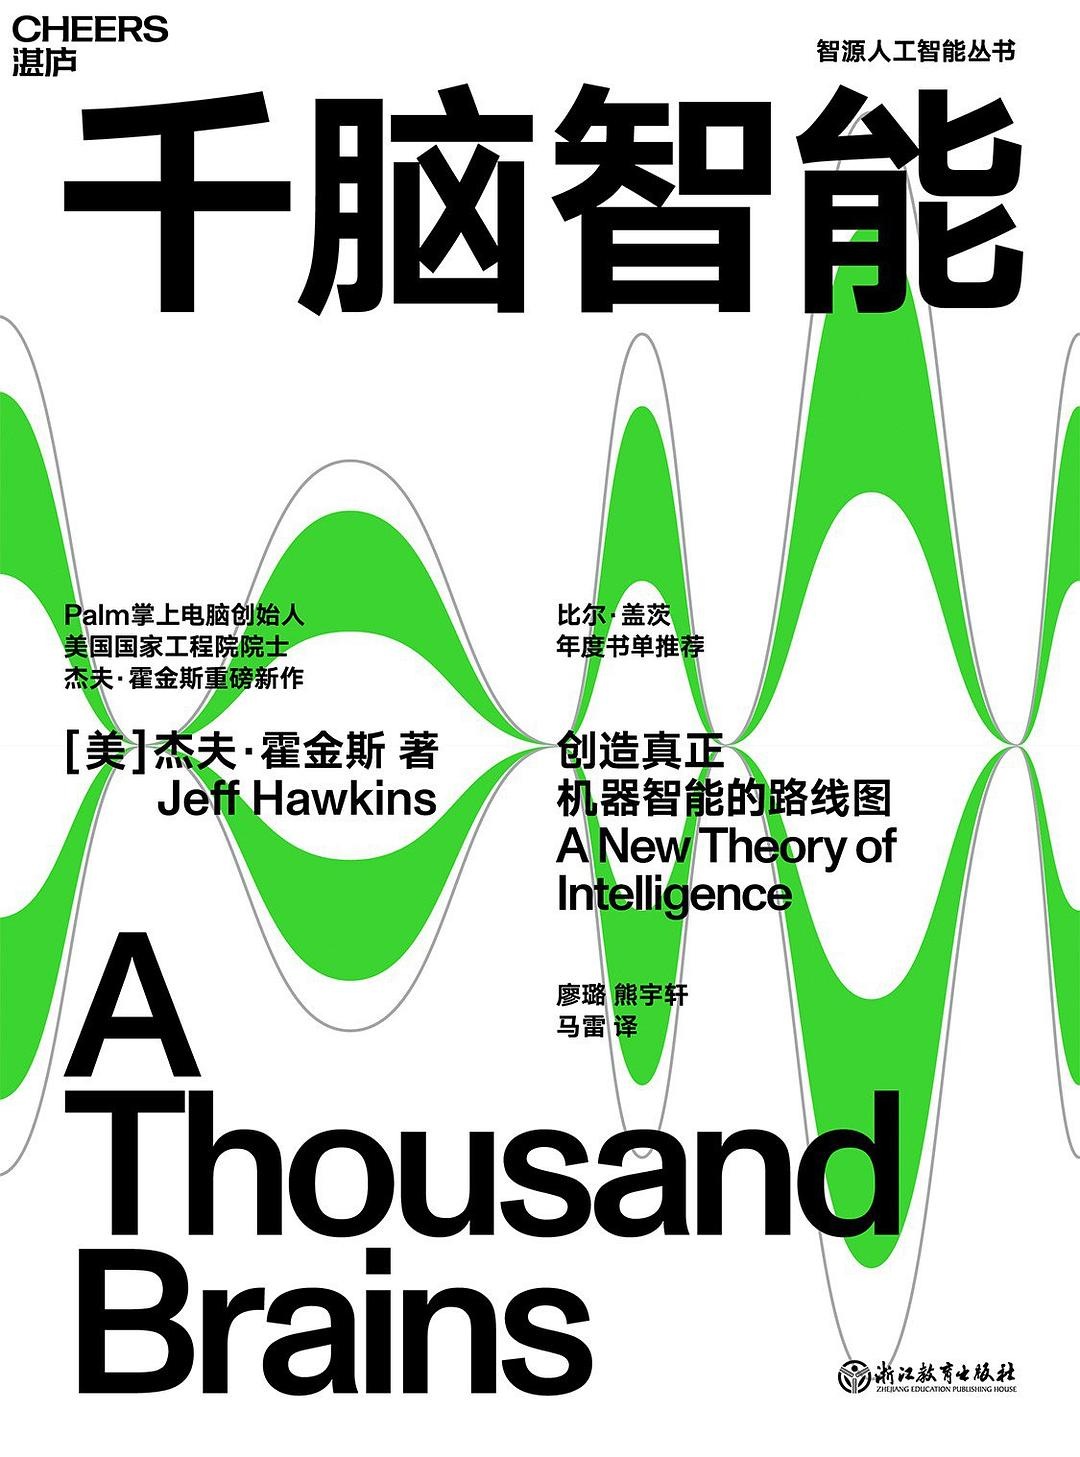
《千脑智能》中文版封面
坑有十五万个,坑坑一样大,装什么都行。
24 个递进问题3 层探索路径笔记依据 · 最小行动笔记导读 · 待龙哥审订

FOLLOW YOUR CURIOSITY

带着问题,一层层读深。

可以从任何一层开始。
阅读进度记录探索,不评定能力。

关于本页依据:本页 24 个问题依据龙哥《千脑智能》的三份原稿整理:lg 笔记、十二步内化,以及波普尔视角的名人阅读法。答案与依据均为对笔记判断的转述,不是原书逐字引文,也未做页码级定位,涉及书中概念只到小节一级,不引用具体段落与原句。本书提出的是一套尚未被证实的假说,页面按假说对待,不按结论引用;皮质柱数量、参考系借用于空间导航、旧脑与新脑二分、投票机制、知识备份五处,我在相应问题里标出了保留的理由,没有替作者把话说完。

基础层 · 看见全貌已探索 0 / 24 问
01这本书到底在讲什么?
笔记·一句话概括

我一句话概括:它把智能从「算得多快」改写成「有多少个模型在投票」。大脑不是一台计算机,是十几万台小机器各自建模、互相竞争的结果。霍金斯站在解剖台上说了一句跟波普尔几乎一样的话——大脑不是接收世界的器官,是猜世界的器官。读它要带一个前提:这是套尚未被证实的假说,不是教科书结论。你要拿它当镜子照自己怎么想事,不是当答案背下来。

最小行动

用一句话写下这本书在讲什么,写完标注:这是作者的假说,还是你已验证的结论。

02十五万个坑,坑坑一样大,这句话什么意思?
笔记·皮质柱:一张重复了十五万次的图纸、近期阅读·十五万个一样大的坑

这是全书的地基。新皮质大约由十五万根皮质柱组成,每根里有一百多个神经元群,层与层连接方式高度一致——把视觉皮层的一小块和运动皮层的一小块放在显微镜下,结构上几乎分不出来。两个功能完全不同的区域,为什么用同一张图纸?霍金斯的答案:功能不由结构决定,由输入决定。一块皮质接上眼睛就是视觉区,接上运动信号就是运动区。同一台机器,换个插头。

最小行动

写下你手上最能代表「同一套结构干不同活」的一件工具或一个人,用一句话说清它换的是什么。

03「脑子分区各管一摊」这个常识被他拆了?
笔记·旧认知二:大脑分区,各管一摊

因为他画的那张地图,画的是输入从哪来,不是计算在哪做。枕叶管看、颞叶管听、布罗卡区管说话,这图被画了上百年,人人都会背。可如果新皮质的柱子结构几乎一样,这张地图就解释不通一件事:不同功能为什么共用同一张图纸。他据此提出一句可以被实验打脸的话——新皮质的所有区域在做同一件事。这句话如果错,后面全部要重写;如果对,教科书第一章要重写。这是我读它最提神的地方。

最小行动

找一张你熟悉的脑区示意图,在旁边写一句「这张图解释不了什么」。

04「知识是走出来的」这个说法怎么理解?
笔记·参考系:大脑用走路来认识世界

你认识一个杯子,不是你存了张杯子的照片,而是你知道手怎么伸过去、怎么转、怎么握。霍金斯说这是大脑把空间导航那套机制借来用了:位置细胞管我在哪,网格细胞管我走过多少格,这套本事被搬去建概念。所以知识是在参考系里的位置,加上在那里感觉到什么。这一句把「知道」从名词变成了动词——能不能在心里从任意一点走到另一点,是检验懂没懂的尺子。

最小行动

挑一件你以为很熟的事,从中间任意一点起,往四个方向各讲一步,记下第一个卡住的地方。

05为什么说感知不是接收,而是核对?
笔记·预测机器:感知不是接收,是核对

因为大脑往下送的信号比往上送的多。你看到的不是眼睛送来的图像,是你预测出来的图像,眼睛送来的那部分只用来纠错。证据很硬:视神经从眼睛到大脑的纤维,比从大脑回到眼睛的少得多;如果感知只是接收,干嘛要那么多下行的线。它顺手解释了那个著名实验——你看不见眼前的大猩猩,因为你的预测里没有它,误差信号被过滤掉了。换句话说,你看见的,多半是你已经相信的。

最小行动

找一件你最近一直坚信、却从没找过反证的事,写下「如果我错了会看到什么」。

06为什么你明知该睡,却还在刷手机到两点?
笔记·旧脑与新脑:人类为什么明知故犯

书里用一个二分回答:旧脑管本能、情绪、生存冲动,新脑管建模、推理、规划。你知道该早睡,那是新脑;你忍不住刷,那是旧脑。作者用它解释人的非理性,也用它解释机器的风险——真正危险的不是超级智能,是一个不讲道理的目标配上超强的新脑。这个二分好用,但有它的软处,我在高层问题里单独说。最实用的一条结论是:讲道理赢不了旧脑,改环境可以。

最小行动

挑一件你明知该做却做不到的事,写下改一个环境动作:手机放哪、什么东西挪走。

07「投票」这个比喻到底在说什么?
笔记·投票机制:为什么你的世界是统一的

如果每根皮质柱都在独立建模,那你感知到的世界为什么会是一个整体,而不是十五万个碎片?霍金斯的答案是长程连接加投票:柱与柱之间横向连接,多根柱对同一个物体给出判断时,通过某种竞争与共识的机制产生统一结论,哪一组被激活得最强你就看到什么。这个解释相当大胆,也相当模糊——票怎么投、权重怎么定、什么时候平票,他都没说清。这是全书最需要证据的一环。

最小行动

用「投票」这个词,把你最近一次和家人拧不到一块儿的事画成两方投票,写下谁在投、投的是什么。

08为什么一群聪明人会一起相信一件假事?
笔记·错误信念:为什么一群人会一起相信假的东西

论证链是这样接上的:既然感知是多模型投票加预测核对,信念的形成就依赖两件事——你看到什么,以及你的模型预测什么。一个错误模型一旦建立,会主动过滤掉不符合它的证据。你不是不肯改,你是看不见该改的地方。把这个机制放到人群里:错误信念就能像病毒一样传播,因为每个接受它的人都会自动屏蔽反证。这不是愚蠢,这是大脑的工作方式。我认为这是全书写得最锐利的一段。

最小行动

写下一条你所在圈子里正在流传的说法,再写一句:如果它是假的,最先会看到什么征兆。

01参考系怎么从空间导航变成思考地图?
笔记·参考系、十二步内化·概念拓扑

位置细胞和网格细胞的发现拿过诺贝尔奖,这是全书唯一完全站得住的部分。作者的推论是:这套空间定位的机制,被大脑借去做了别的事。你认识一个杯子,是在心里沿着它的表面走一圈——摸到杯口,转过来,摸到把手,往下,摸到底。概念因此是「在心里走动」走出来的。这也解释了两件小事:小孩要用手抓东西才记得住;我们理解抽象概念爱打比方,因为比方就是给抽象搭一个能走的空间。

最小行动

给你最近在学的一个抽象概念造一个「能走一遍」的空间比喻,写三句。

02他反对深度学习的理由,哪一条最硬?
笔记·深度学习批判、笔记·我的评断(风险二)

他给了三条:一,这些系统没有世界模型,换个角度、换个光照就崩;二,它们不移动,学不到动作与后果的对应关系;三,它们的目标是外挂的,由人设定,系统本身没有内在目标结构。三条都有反驳余地,但构成一个完整而锋利的立场。我个人最认第二条:不动的东西没法从后果里学,这是硬约束,不是观念问题。也要提醒一句,这书写于几年前,那时的大模型还没显出后来的能力。

最小行动

挑一个你每天用的模型或工具,写下它「换什么输入就崩」的三个具体例子。

03为什么作者坚持机器一定要有身体?
笔记·具身运动、十二步内化·反例检验(反例二)

因为参考系这东西本质是从移动中学来的。你不移动,就没有位置变化,就没有「从这点到那点会遇到什么」的经验,所以造不出能走动的模型。反对意见也很硬:人类自己的抽象思维能脱离身体运行,数学家不用动手就能证明定理。作者的回应是抽象思维借用了空间模型——你证明定理时在心里移动的是概念,不是手脚,但用的还是同一套导航机制。这个回应漂亮,但不可证伪,只能算一个说法。

最小行动

找一个你用手指比划着才想得通的抽象概念,写下你在比划中「移动」的是什么。

04「意识即模型」解决了难问题吗?
笔记·意识即模型:把难问题拆掉

他的处理方式是不承认有需要单独解释的东西:大脑里有很多模型,其中一个代表我自己,当它参与投票并和其他模型达成一致,就产生了「我在体验」的感觉。这把主观体验还原成「一个模型的自我指涉」,聪明省事。但没回答最刁的一问:为什么这些计算会感觉像什么。他能解释「我知道我在看红色」,解释不了「红色看起来是这样」。把哲学难题改写成工程问题,这本书已经完成了它该做的事。

最小行动

写下一个你一直没想通的问题,然后把「它为什么这么难」改写成「要解释哪几件事」。

05「十五万」这个数字在理论里到底干什么?
笔记·反例检验(反例六)、十二步内化·反例检验(反例六)

这是我认为全书最大的方法论漏洞。为什么是十五万根柱,不是一千根也不是一千万根?千脑这个数字在理论里扮演什么角色,作者始终没说清。如果数量不重要,「千脑」就只是个好听的比喻;如果数量重要,理论就该给出一个可检验的关系。这一个空缺把整本书的性质定了:它是一个有说服力的猜想,不是一把标定过的尺子。看一本书的分量,先看它最关键那个数字有没有被用起来。

最小行动

写下这本书里最关键的那个数字,再写一句:它被用起来了吗,还是只是个说法。

06「投票」这个说法有没有漏掉什么?
波普尔读法·第三部分:可证伪性

有。波普尔那一刀切得很准:投票是社会过程,有票数、有权重、有程序,霍金斯用了这个词,读者会自动补上这些细节,而他一个都没给。他答不上来「如果投票理论错了,我们会看到什么」。更硬的一层是:多模型怎么产生单一的主观体验?说它们投票统一了,等于说它们统一了——统一本身才是要解释的东西。所以正确的读法是把投票当成一个待检验的假设,不是已说明的机制。

最小行动

挑你工作里一个靠投票拍板的决定,写下若这个机制错了会看到什么。

07「必须具身」这条在语言模型面前很被动吗?
笔记·反例检验(反例二)、十二步内化·反例检验(反例二)

大语言模型没有身体、不能移动,却表现出相当强的语言理解与推理能力。作者会说那不是真智能,只在做统计。这个回应逻辑上成立,但它把智能的定义收得太窄——窄到无法被证伪,不是科学主张,是立场。这里有两层要分清:批评「模型没有世界模型」是一回事,断言「没有身体就不可能有智能」是另一回事。第一条今天需要修正,第二条至今没人能证伪,所以它停在信仰那一侧。

最小行动

把「模型没有世界模型」和「智能必须具身」分开写,各写一句你凭什么判断。

08第三部分为什么被我看成随笔插进来?
笔记·书的结构与骨架、笔记·我的评断(风险三)

全书三部分强度不均:第一部是内行话,最扎实;第二部是论战,最尖锐;第三部最松散。后面那部分谈错误信念怎么绑架群体、人类知识要不要备份到太空——有意思,但跟前面的神经科学论证之间只有一层薄薄的连接。波普尔看得更准:他说自己判断不了作者为什么要把三种不同性质的内容缝在一本书里。如果只读一段,读第一部;第三部当作者的个人忧虑读,别当成论证的延伸。

最小行动

把一本书拆成「哪部分在论证、哪部分在抒发」两栏,各列一条。

01这本书最容易被误读成什么?
笔记·皮质柱与旧认知二、近期阅读·十五万个一样大的坑

最容易被读成「大脑容量更大所以更聪明」,不是「多模态就是多几个皮层区」。霍金斯说的恰恰相反:坑有十五万个,坑坑一样大,装什么都行。关键不在容量,在结构:同一张图纸接不同的输入,就长出不同的功能。所以你读它最该带走的一句话不是「大脑很厉害」,是「差别往往不在有多少,而在于同样的东西被怎么组织」。这判断用在人身上一样成立:懂一件事不等于拥有更多,是拥有通路。

最小行动

挑一件你以为自己缺「量」的事,写下它缺的到底是量还是结构。

02千脑理论现在到底算不算科学?
波普尔读法·第三部分:可证伪性、笔记·反例检验(反例一)

按波普尔的尺子,我给它打个折中的分:结构一致那一条是解剖学陈述,可以被切片和染色推翻;参考系那一条有位置细胞与网格细胞撑着,能设计实验;投票那一条不及格,因为说不出「如果它错会看到什么」。我的判断是三成科学、五成待检验猜想、两成哲学随笔,这比例不算差,大部分畅销科学书比这更糟。但整本书仍是假说:它给的是一个有说服力的猜想,不是一个已确立的结论,别当定论。

最小行动

用「如果我错了会看到什么」给三个核心主张各打一个分:及格、待定、不及格。

03大脑只过滤反证,科学怎么还能进步?
波普尔读法·第四部分:你其实写了一本政治哲学

这是波普尔读法里我最欣赏的一段。他认为大脑爱猜是固有缺陷,正因为是固有缺陷,才需要制度来对冲:科学之所以能进步,不是因为科学家的脑子比常人更少偏见,而是因为科学发明了一套让偏见互相打架的制度——公开、重复、同行评审、可反驳。他给作者的评语是「手里有一把很好的钥匙,却只用它开了一扇小门」。我认同:机制可以调,制度可以补,但作者没往这边走。

最小行动

为你正在坚持的一个判断,设想一个能让它被反驳的机制:谁来挑刺,什么算证据。

04「保存知识到太空」这个方案,问题出在哪?
笔记·知识档案、波普尔读法·第二部分:你的模型属于哪一层

出在它把知识当成一堆存在脑子里的东西,搬出来就行。波普尔的判断更狠:你备份的是纸,不是知识,知识活在争论里,不在硬盘里——一本教科书如果没有人读、没有人用、没有人质疑,它就不再是知识。再加一层更朴素的难处:谁来决定备份什么?如果备份里没有你的语言、你的宗教、你的诗,那备份的还是人类知识吗?作者没有回答,只是给了一个工程方案。这是全书最天真的一处。

最小行动

写下三样你觉得值得备份给一百年后的人的东西,再标出哪一样只是信息、哪一样才带得过去。

05这套理论能改造我的学习方式吗?
十二步内化·跨界生发(与教育的交叉)、十二步内化·事上磨练

能,而且它给的是机制解释,不是口号。孩子学分数,光看图不行,要切苹果、分积木、走格子;刷题能提分但不一定长理解,因为刷题建立的是映射,不是模型。这条对成年人同样成立——知识如果只有一条输入通道,它在你的系统里就是薄的。我的做法是给每件想真懂的东西找一个必须动手的动作:写出来、讲出去、做一遍、走一遍。判断标准只有一条:能不能在心里从任意一点走到另一点。

最小行动

选一件你以为自己懂了的事,找一个必须动手才能完成的小任务,今天做完。

06「模型会过滤反证」怎么用在带团队上?
十二步内化·跨界生发(与组织管理的交叉)、波普尔读法·第四部分

一个团队反复犯同一类错,不是能力问题,是他们共享了一个错的模型,已经看不见反证了——每个接受者都自动屏蔽反证。我的解法不是加强培训,是引入一个模型不同的人:让没在这个模型里泡过的人来挑毛病,等于给组织装一道外部信号。这跟科学制度是一个道理:偏见消不掉,但可以让偏见互相打架。用在家庭里也一样:孩子认准了一个说法,大人跟他争没用,得换个人从另一个角度说。

最小行动

找出你团队里那个谁都没人反驳的共识,写下你今天要找谁来挑一次刺。

07把作者的知识备份,改成个人怎么用?
十二步内化·跨界生发(与写作的交叉)、十二步内化·认知同化(老庄视角)

顺着他的工程思路收一点:你的知识也不能靠一个硬盘保住,得有冗余、有人用。我的版本是三条加一条规则——每个项目留一份外人能看懂的说明,因为没人用的文档等于纸;每个观点留一条「如果我错了会看到什么」;每本书留一段自己的话,不抄作者的句子;每个结论都要有一个还在用着的人。把全人类知识备份的野心放到个人身上也不为过:连自己脑子里的模型都还没搞清,就想备份全世界。

最小行动

给手头一个项目写一份外人也能照着跑的说明文档,今天写出第一段。

08普通读者读完这本书,最该带走什么?
十二步内化·破坏与重塑、十二步内化·佛学视角深化、笔记·金句摘录

三句话。第一句是核心的机制描述:你看见的,多半是你已经相信的——而这不是道德批评,是机制。第二句是它的姿态:提出一个可以被实验打脸的说法,我们讲观点常常无法反驳,那不是严谨,是回避。第三句是我的取舍:对具体的事,要把模型磨准,该做实验就做实验,该找反证就找反证;但人生态度上要知道模型永远是模型,不是世界本身——准的模型仍然是模型。这半个提醒是本书最缺的。

最小行动

写下一句你的模型提醒语,贴在每天看得见的地方,今天就贴。

你的想法会保存在当前浏览器。

READ THROUGH DIFFERENT LENSES

一本书,三种笔记。

从理解作者,到形成自己的判断。
原稿已接入,展开即可阅读。

每篇笔记都是一条不同的阅读路径。可以逐篇展开,也可以下载原始 Markdown。

01龙哥笔记核心主张、六个反例与三处风险约 6,241 字词30 个章节
个人阅读笔记

记录皮质柱、参考系、预测机器、投票机制等核心概念与三条对深度学习的批评,以及六处反例检验和结构、说理、随笔三处风险判断。

下载原始 Markdown ↓

杰夫·霍金斯《千脑智能》

⚠️ 作者核验与体例说明

杰夫·霍金斯,美国发明家、计算机科学家与神经科学家。掌上电脑的早期开创者之一,二〇〇三年当选美国国家工程院院士,创办过红杉神经科学研究所与一家专做脑启发计算的公司。他上一本书《创智慧》写于二〇〇四年,提出「大脑是记忆-预测系统」;这本《千脑智能》是他十七年后的修订与扩展。

第一件必须交代的事:书名与版本。 书单作「千脑」,中文正式书名是《千脑智能》,浙江教育出版社(湛庐)二〇二二年九月出版,廖璐、熊宇轩、马雷合译,三百一十三页。本文文件名用正式全名,与「达·芬奇传」按全名收录的先例一致。 台湾星出版二〇二三年另出繁体版,书名改作《千脑智能新理论》,译者许瑞宋,三百五十二页。

第二件必须交代的事:原书为英文写作,下文一律用中文译名与中文表述,不夹原文。 书里那些脑区缩写、公司名、实验代号,我一律给中文说法;凡学界通行的缩写,也只写中文意思。

第三件必须交代的事:这是一本假说之书,不是教科书。 作者在书里反复强调他的理论「尚未被证实」。读者如果把这本书当成已经确立的科学结论,会犯两类错误:一是高估它的确定性,二是低估它的野心。

第四件必须交代的事:本文不作页码级引用。 我据的是章节结构、公开的作者演讲与书评。凡标「作者认为」处,只到章,不到页;凡属笔者推演者,另行注明。

开篇 · 这本书挑战了什么旧认知

旧认知一:智能等于算力加数据

过去十年最流行的一套信念是:只要模型足够大、数据足够多、算力足够强,智能就会「涌现」。这套信念把智能定义成一个规模问题。

这本书说:方向错了。 作者的观点是,今天这些系统学的是统计相关性,不是世界的结构。它们能预测下一个词,却不能在一个房间里找到自己的杯子。因为真正的智能不是从数据里找规律,而是建立一个可以「在里面走动」的世界模型。

他给的比喻很硬:人类不是靠模仿鸟飞起来的,是靠理解空气动力学。同样,我们不会靠堆参数造出智能,得先搞清大脑怎么工作。

旧认知二:大脑分区,各管一摊

教科书式的说法是:枕叶管看,颞叶管听,布洛卡区管说话,运动皮层管动作。这套地图被画了上百年,人人都会背。

这本书说:这张地图画的是「输入从哪来」,不是「计算在哪做」。 作者的核心观察是:新皮质里那几十万根皮质柱,结构几乎一模一样。 视觉皮层的一根柱和运动皮层的一根柱,在解剖上你分不出来。

如果结构相同,功能就不可能是「各管一摊」。 他的推论是:每一根柱都在学同一件事——世界的模型。 区别只在于它们接收的输入不同。这个推论如果成立,整个神经科学的教科书要重写第一章。

旧认知三:知识是抽象的,与身体无关

我们习惯把「知道」当成一件纯大脑的事:知识存放在脑里,身体只是执行器。这套观念支撑了从课堂到考试的一整套教育制度。

这本书说:知识长在「动作」里。 你认识一个杯子,不是因为你存了一张杯子的图片,是因为你知道手怎么伸过去、怎么转、怎么握。知识是「在参考系里的位置」加上「在那里感觉到什么」。

推论很激进:一个不能动的东西,学不会真正的知识。这是他批评纯软件路线的根本理由,也是他坚持「具身」的原因。

旧认知四:意识是科学够不着的难问题

哲学上有个著名的划分:大脑的处理过程是「容易问题」,主观体验是「难问题」。很多研究者认为后者永远无法用物理解释。

这本书说:意识不需要神秘解释。 作者认为,所谓「自我」只是大脑里众多模型中的一个,它和其他模型一样,是被建构出来的。当大量模型通过投票达成一致,你就体验到一个统一的、属于「我」的世界。

这个说法我不完全接受,但它至少把问题从「神秘」拉回了「机制」。一本书能把一个哲学难题改写成工程问题,就已经完成了它该做的事。

旧认知五:机器的威胁来自它太聪明

所有关于人工智能威胁的讨论,几乎都建立在同一个假设上:机器会变得比我们聪明,然后不再需要我们。于是大家讨论「对齐」,讨论「关掉开关」。

这本书说:威胁不在智能那一头,在目标那一头。 智能是「怎么做事」,目标是「为什么做事」。目标来自大脑里更古老的那部分——那部分不讲道理,只管欲望。

所以他认为真正危险的不是超级智能,是「一个被设定好的旧脑配上超强的新脑」。 这个判断和主流叙事正好相反,值得认真对待。

一、目的判定

第一层,提出一个可检验的科学假说。 作者要说的是一句可以被实验打脸的话:新皮质的所有区域在做同一件事。 这一层是他的本行。

第二层,给人工智能指一条路。 他不满足于解释大脑,他要造机器。这一层带着明显的挑战姿态:他点名批评当下最热的路线。

第三层,一次关于人类处境的忧虑。 书的后半部分突然转向:错误信念为什么会扩散、人类知识要不要备份到太空。这一层是作者的个人立场,也是这本书最像「预言」的部分。

二、一句话概括

《千脑智能》真正做的事,是把「智能」从「算得多快」改写为「在多少个模型里走过多少步」,然后告诉你:大脑不是一台计算机,是十万台小机器投票的结果。

三、书的结构与骨架

全书分三部分,逻辑线很清晰:先讲大脑怎么工作,再讲机器智能怎么做,最后讲这件事对人类意味着什么。

第一部是解剖与理论。 从新皮质的统一结构讲起,引入皮质柱、参考系、位置细胞,最后给出「千脑」这个名字的由来:**不是一颗大脑,是成千上万个模型。

第二部是机器智能。 他讨论现有深度学习的局限,提出「具身 + 移动 + 参考系」的路线,并给出他自己公司的实验方向。

第三部是人类的处境。 这一部最不像科学书:他讨论错误信念如何绑架群体、人类知识如何保存、要不要把文明备份到别的星球。

结构上的特点:三部之间的强度不平均。 第一部最扎实,是内行话;第二部最尖锐,是论战;第三部最松散,是随笔。读者如果只想读一部分,读第一部。

四、核心概念与论证

关键词: 皮质柱、参考系、位置细胞、预测机器、投票机制、旧脑与新脑、具身运动、世界模型、错误信念、通用人工智能、深度学习批判、意识即模型、知识档案、智能的复制、语言局限、目标与对齐

4.1 皮质柱:一张重复了十五万次的图纸

新皮质是大脑最外层那层褶皱,人类的新皮质特别大。但作者强调的不是大小,是重复。 新皮质由大约十五万根皮质柱组成,每根柱里有一百多神经元群,层与层之间的连接方式高度一致。

这个「一致性」是全书的地基。 如果你把视觉皮层的一小块和运动皮层的一小块放在显微镜下,结构上几乎无法区分。这在一个「分区各司其职」的框架里是很难解释的:两个功能完全不同的区域,为什么用同一张图纸?

作者的答案是:功能不是由结构决定的,是由输入决定的。 同一台机器,接上摄像头就成了视觉区,接上运动信号就成了运动区。这个想法简单到近乎粗暴,但它解释力很强。

4.2 参考系:大脑用「走路」来认识世界

这是全书最核心的机制,也是最需要耐心读的一段。

大脑里有一类神经元,专门表示「我在空间里的位置」——位置细胞表示「我在哪」,网格细胞表示「我走过多少格」。这两位科学家的发现拿过诺贝尔奖,这是这本书唯一完全站得住的部分。

作者的推论是:这套空间导航的机制,被大脑借来做了别的事。 你认识一个杯子,不是你存了它的照片,而是你在心里「沿着它的表面走了一圈」:摸到杯口,转过来,摸到把手,往下,摸到底。

也就是说:概念是「在心里走动」走出来的。 你之所以知道杯子是什么,是因为你的模型里有「从任意一点出发,往哪个方向移动,会遇到什么」这套对应关系。

这个说法解释了很多事。 比如为什么小孩要用手抓东西才能记住;为什么我们理解一个抽象概念时喜欢打比方(比方就是给抽象概念搭一个可以走的空间)。

4.3 预测机器:感知不是接收,是核对

作者上一本书就提出过:大脑是一个预测机器。你看到的不是眼睛送来的图像,是你预测的图像,眼睛送来的信号只用来纠错。

证据很硬:视神经从眼睛到大脑的纤维,比从大脑回到眼睛的纤维少得多。如果感知只是接收,为什么要这么多「下行」的线? 唯一合理的解释是:大脑在往下送预测,上行只送误差。

这个机制一旦成立,「看」这个动作的性质就变了。 看不是被动接收,是主动核对。你之所以「看不见」明显的东西(比如著名的看不见的大猩猩实验),是因为你的预测里没有它,误差信号被你过滤掉了。

4.4 投票机制:为什么你的世界是统一的

如果每根皮质柱都在独立建模型,那为什么你感知到的世界是一个整体,而不是十五万个碎片?

作者的答案是长程连接加投票。 皮质柱之间有横向连接;当多根柱对同一个物体给出判断时,它们通过某种竞争-共识机制产生一个统一结论。哪一组模型被激活得最强,你就「看到」什么。

这个解释相当大胆,也相当模糊。 「投票」是一个比喻,不是机制。他没有说清楚票怎么投、权重怎么定、什么时候会平票。 这是他这本书最大的软处,后面我在反例里会再说。

4.5 旧脑与新脑:人类为什么明知故犯

书里有一个反复出现的二分:旧脑负责本能、情绪、生存冲动;新脑(新皮质)负责建模、推理、规划。

这个二分解释了一个日常现象:你知道该早睡,你还是刷手机到两点。知道是新的,想要是旧的。

作者用它来解释人类的非理性,也用它来解释机器的风险:如果将来造出一个智能系统,它的「目标」部分对应旧脑,「智能」部分对应新脑,那么危险的不是它聪明,是它的目标不可商量。

4.6 错误信念:为什么一群人会一起相信假的东西

书的后半段有一个转折,我认为是全书写得最锐利的地方。

他的论证是:既然感知是「多模型投票 + 预测核对」,那么信念的形成就依赖两件事——你看到什么,以及你的模型预测什么。 一旦一个错误模型被建立,它会主动过滤掉不符合它的证据。你不是不肯改,你是看不见该改的地方。

把这个机制放到人群里,就得到他的结论:错误信念可以像病毒一样在群体里传播,因为每个接受它的人都会自动屏蔽反证。这不是愚蠢,这是大脑的工作方式。

这段读起来像政治评论,但它的根在神经科学。 我认为这是这本书最值得单独拿出来讲的一章。

4.7 深度学习批判:他到底在反对什么

作者的态度很明确:当下的主流路线(大数据、大模型、大算力)不会通向真正的智能。

他的理由有三条,我逐条记下来:
一,这些系统没有世界模型,只有输入到输出的映射;换个角度、换个光照,它们就崩。
二,它们不移动,因此学不到「动作与后果」的对应关系。
三,它们的目标是外挂的,由人设定,系统本身没有内在的目标结构。

这三条都有反驳余地(后面反例里说),但它们构成了一个完整而锋利的立场。作者不是外行骂街,他是拿自己二十年的实验结果在赌。

4.8 具身运动:为什么机器人一定要有身体

他的主张是:智能需要一个能移动的身体。因为「参考系」这个东西,本质上是从移动中学来的。 你不移动,就没有位置变化,就没有「从这点到那点会遇到什么」的经验。

这个主张在机器人学里有大量支持者,也有大量反对者。 支持者的理由是:所有真实智能的载体都有身体。反对者的理由是:人类自己的抽象思维,明显能脱离身体运行(数学家不需要动手就能证明定理)。

作者的回应是:抽象思维是借用了空间模型。 你证明定理时在心里「移动」的是概念,不是手脚——但用的还是同一套导航机制。这个回应很漂亮,但它不可证伪,所以只能算一个说法。

4.9 意识即模型:把难问题拆掉

他处理意识的方式是:不承认有一个需要单独解释的东西。

他的说法是:大脑里有很多模型,其中一个模型代表「我自己」。当这个自我模型参与投票,并和其他模型达成一致时,就产生了「我在体验」的感觉。

这个说法把「主观体验」还原成了「一个模型的自我指涉」。 它聪明,也省事。但它没有回答那个最刁的问题:为什么这些计算会「感觉像什么」?他能解释「我知道我在看红色」,解释不了「红色看起来是这样」。

4.10 知识档案:一个工程师的浪漫

书末他提出一个主张:人类应该把知识备份到太空,比如月球或更远的地方,以防文明中断。

这个提议在书里显得突兀,但很符合他的性格。 他是个工程师,工程师遇到风险的第一反应是冗余:重要数据要有备份,关键系统要有第二套。

这个提议的漏洞也很明显:谁来选哪些知识值得备份?按什么标准?如果备份里没有你的语言、你的宗教、你的诗,那备份的还是「人类知识」吗?作者没有回答这些问题,他只是提了一个工程方案。

五、我的评断

这本书最强的地方,是它敢给一个统一解释。 神经科学里充斥着「这个区域管这个、那个区域管那个」的碎片,很少有人敢说「所有区域其实在做同一件事」。 这个野心值得尊敬,哪怕最后被证伪。

第二强的地方,是它的可操作性。 他不是在写哲学,他给出了具体的预测:如果千脑理论对,那么一个只有少量皮质柱的系统应该表现出特定的缺陷;如果对,那么加上移动能力应该显著提升学习效率。这些都可以做实验。

风险一:核心机制靠比喻支撑。 「投票」是比喻,「参考系借用于空间导航」是推论,两者之间缺一个可验证的中间环节。 读者会觉得「说得通」,但「说得通」不等于「是真的」。

风险二:他对主流路线的批评,有一部分已经过时。 这本书写于几年前,那时的大模型还没有展现出后来的能力。今天回看,他说「这些系统没有世界模型」这句话,至少需要修正——它们显然学到了某种世界结构,只是不知道那结构长什么样。

风险三:第三部分拖累了整本书。 关于错误信念和知识备份的讨论,读起来像两篇独立的随笔插进来。它们有意思,但它们和前面的神经科学论证之间,只有一层薄薄的连接。

六、🛡️ 反例检验

反例一:千脑理论目前仍是假说,缺决定性证据。
「每根皮质柱都建完整模型」这个说法,实验上还没有定论。已知的是柱的结构相似,未知的是它们的功能是否真的同构。 相似的结构可以支持不同功能,这在生物学里很常见。读者要清楚:这本书给的是一个有说服力的猜想,不是一个已确立的结论。

反例二:「必须具身才能智能」被近年的系统部分反驳。
大语言模型没有身体,不能移动,却表现出相当强的语言理解与推理能力。作者会说那不是真智能,只在做统计。 这个回应逻辑上成立,但它把「智能」的定义收得太窄——窄到无法被证伪,就不是科学主张,是立场。

反例三:旧脑与新脑的二分,是被神经科学批评过的简化。
「爬虫脑、哺乳脑、新皮质」这套三分法在比较解剖学上早就有争议:脑区不是这样一层层叠上去的,演化是改造旧结构而不是叠加新结构。 作者用这个二分来解释人的非理性,很方便,但不准确。

反例四:「投票」解释不了绑定问题,只是换了个说法。
多模型如何产生单一的主观体验?说「它们投票」等于说「它们统一了」,但统一本身才是需要解释的东西。 这是把问题往后推了一步,不是解决了它。

反例五:知识备份的方案回避了政治问题。
谁来决定备份什么?一个由技术精英决定的档案,反映的是他们的世界观。把这件事说成纯工程问题,是这本书最天真的一处。

反例六:这套理论解释不了的地方——数量。
为什么是十五万根柱?为什么不是一千根或一千万根?「千脑」这个数字在理论里扮演什么角色,书里始终没说清。 如果数量不重要,那这个理论的名字就只是个比喻;如果数量重要,那它应该给出一个可检验的关系。这个空缺,是这本书最大的方法论漏洞。

七、与我的关系

第一,它给了我一个新比喻:知识是「能走通的路」。 以前我把「理解」当成「能复述」,现在我会问:我能不能在心里从任意一点出发,走到另一点? 走不通,就是没懂。

第二,它解释了我一个老毛病:我看不见我不想看的东西。 因为感知是预测加纠错,我的预测越强,纠错越难进来。这比「我有偏见」这个说法具体得多,也可怕得多。

第三,它让我对「堆资源」这件事保持警惕。 无论是做内容还是做产品,规模不解决结构问题。一个错误的模型,喂更多数据只会更自信。

八、延伸方向

方向一:读认知神经科学的实验文献。 这本书是假说,要判断它的分量,得去看真实实验。从位置细胞与网格细胞的原初论文读起,是最稳的入口。

方向二:读具身认知这一支的哲学。 「知识长在动作里」这个想法,在现象学里已经讨论了一百年。两条线对照着看,会发现工程师和老哲学家在说同一件事,用两套语言。

方向三:读人工智能的批评史。 每一代主流路线都有人批评。把过去六十年的批评串起来看,会发现批评的措辞惊人地相似,而技术一次次绕过去了。 这本身值得警惕。

九、主题书对话

与《我们为什么要睡觉》对话:两本都是科学家写的普及书,都提出一个「被忽略的基础」。差别是睡眠那本有大量硬数据支撑,这本更多是推论。 读这两本可以对照看:什么样的科普是有底气的,什么样的是有野心的。

与《自私的基因》对话:都在做同一件事——用一个简单的机制解释一个复杂的现象。差别是基因那本的机制已经被大量证据支持,这本还在等。

与《思考,快与慢》对话:两本都在解释人的非理性。一本用两个系统,一本用新旧脑。 两套模型都很有解释力,也都面临同样的批评:过于整齐。

与《解码者》对话:一本讲「我们怎么读生命的密码」,一本讲「我们怎么读大脑的密码」。两本书都在说同一件事:理解一个系统,靠的不是观察它的输出,是搞清它的内部结构。

十、可转化的内容选题

🎬 视频号选题

选题一:你不是用眼睛看世界,你是用预测看世界。
从「大脑往下送的信号比往上送的多」讲起,讲为什么你会看不见眼前的大猩猩。落点:你看见的,多半是你已经相信的。

选题二:为什么你明知该睡却还在刷手机。
用旧脑与新脑的二分讲人的自相矛盾:知道是新的,想要是旧的。落点:改变行为不靠说服自己,靠改环境——因为讲道理的那部分管不了想要的那部分。

选题三:一群聪明人怎么会一起相信一件假事。
讲错误信念的传播机制:模型一旦建立,就会自动过滤反证。落点:不是他们蠢,是他们的过滤器关上了——而我们每个人的过滤器也在关。

📝 公众号选题

选题一:堆更多数据,救不了一个错的模型。
从作者对主流路线的批评讲起,讲「世界模型」和「统计相关」的区别。落点:规模不解决结构问题——这条对做产品、做内容、做研究都成立。

选题二:认识一个杯子,靠的是在心里走一圈。
讲参考系与位置细胞,讲「知识是能走通的路」。落点:判断自己懂没懂,只问一句——我能不能从任意一点走到另一点。

页脚:汉字与全角合计七千一百四十七字(实测)。

02十二步内化把「模型会过滤反证」搬进今天约 5,550 字词20 个章节
阅读内化记录

从核心命题的三层到概念拓扑、七种智慧传统对读、破坏与重塑、事上磨练与跨界生发,把大脑机制落到教育、产品、组织与写作四个场景。

下载原始 Markdown ↓

千脑智能 · 十二步内化

原书为英文写作,简体中文版由浙江教育出版社(湛庐)二〇二二年九月出版,廖璐、熊宇轩、马雷合译,三百一十三页;台湾繁体版另题一名。下文一律用中文译名与中文表述,不夹原文。凡标「作者认为」处,据译本按章题定位,不作页码级引用;凡属笔者推演者,另行注明。本书提出的是一套尚未被证实的假说,本文按假说对待,不按结论引用。

第一步:一句话概括

《千脑智能》真正做的事,是把「智能」从「算得多快」改写成「在多少个模型里走过多少步」——大脑不是一台计算机,是十几万台小机器投票的结果。

第二步:核心命题的三个层次

表层命题:新皮质的所有区域在做同一件事。
这是一句可以被实验打脸的话,也是全书的地基。如果它错,后面全部要重写。

中层命题:知识不是存下来的,是走出来的。
你认识一个东西,是因为你心里有一套「从任意一点出发,往哪走会遇到什么」的对应关系。这一层把「知道」从名词变成了动词。

深层命题:真正的机器智能必须具身、必须移动、必须有内在目标。
这一层是全书的赌注,也是它最有争议的地方。作者拿自己二十年的实验在赌这条路线。

第三步:概念拓扑

[皮质柱]——新皮质里约十五万根结构高度一致的功能柱;结构相同意味着功能不由结构决定,而由输入决定。
[参考系]——大脑借用空间导航机制建立的概念结构;认识一个物体等于知道沿着它移动会遇到什么。
[位置细胞]——表示「我在哪」的神经元,与网格细胞共同构成大脑的定位系统,这是本书唯一完全站得住的部分。
[预测机器]——感知不是接收而是核对;下行信号送预测,上行信号只送误差。
[投票机制]——多根皮质柱各自建模后通过长程连接达成一致,产生统一的知觉;这是全书最需要证据也最缺证据的一环。
[旧脑与新脑]——旧脑管本能与欲望,新脑管建模与规划;人明知故犯,是因为讲道理的部分管不了想要的部分。
[具身运动]——智能需要一个能动的身体,因为参考系本身是从移动经验里长出来的。
[世界模型]——与统计相关相对的东西;不是输入到输出的映射,而是一个可以在里面走动的结构。
[错误信念]——模型一旦建立就会主动过滤反证;群体共享错误信念时,每个人都看不见该改的地方。
[通用人工智能]——作者认为它不会从堆参数里出现,只会从理解大脑机制里出现。
[深度学习批判]——三条理由:没有世界模型、不移动、目标外挂;这三条都有反驳余地,但立场完整。
[意识即模型]——自我只是众多模型中的一个,投票达成一致就产生「我在体验」的感觉。
[知识档案]——把人类知识备份到太空以防文明中断;一个工程师的冗余思维,也是一个政治难题。
[智能的复制]——造机器智能不是造一个更快的计算器,是造一个会建模、会移动、会有目标的东西。
[目标与对齐]——危险不在智能那一头,在目标那一头;被设定好的欲望配上超强算力才是风险。

第四步:认知同化(七种智慧传统)

🏮 王阳明视角

阳明讲「知行合一」,说知而不行只是未知。这句话被念了五百年,一直被当成道德要求。这本书把它变成了神经机制。

霍金斯说的是同一件事的另一个版本:知识存储在「动作与感觉的对应关系」里,所以你没法只靠看就懂一个东西。你得动。 一个只接收不输出的系统,学不会真正的知识。

拿阳明格竹子的故事来对照,会看出很有意思的一层。 他对着竹子看了七天,想从竹子里格出天理,结果病倒。按这本书的说法,他缺的不是诚意,是参考系——他没有绕着竹子走、摸它、砍它、用它,所以他的大脑里没有建立起那个可以「走进去」的模型。

这不是在给阳明挑错。 阳明后来讲的「事上磨练」,恰恰就是要人在做事中修,而不是在静坐中修。两个人隔着五百年,用两套语言说了同一句话:不动手,就不算懂。

☸️ 佛学视角

佛学讲「诸行无常」,说一切都在流变,没有恒常的东西。这本书的感知模型几乎是这句话的技术版:你看到的不是一张固定的图像,是一个不断被更新的预测,每次眼动、每次呼吸、每次转头,模型都在重算。

更接近的是「无我」。 霍金斯说自我只是众多模型之一,是投票产生的一个结果。佛学说的「无我」,也是这个意思:那个你以为坚固的「我」,是五蕴和合暂时聚起来的。 两边都说它是「组装出来的」,不是「本来就在的」。

但两边有一个根本分歧。 佛学讲无我是为了离苦,所以要放下对「我」的执取;霍金斯讲无我是为了解释机制,解释完就完了,没有下一步。一个是要解脱,一个是要造机器。 走在同一条路上,目的地完全不同。

🌿 老庄视角

老子讲「为学日益,为道日损」。这本书恰好是「为学日益」的极致:它要把大脑的每一层都拆开,把智能的每一步都写清。

但庄子会喜欢它的一个想法:知识的本质是「走」。庄子讲庖丁解牛,说那人「以神遇而不以目视」——他不再用眼睛看牛,而是顺着骨节的空隙走刀。这就是一个建立得极其精细的参考系:他知道从哪进、往哪走、哪里会卡住。霍金斯会说,庖丁的脑子里有一套牛的模型,而且这套模型能被他「走」得极顺。

庄子还会提醒一句危险的:「吾生也有涯,而知也无涯。以有涯随无涯,殆已。」这本书记录了人类想把自己的全部知识备份到太空的野心。 从庄子的角度看,这个野心本身就是「殆」——你连自己脑子里的模型都还没搞清,就想去备份全人类。

📖 孔孟视角

孔子讲「学而时习之」。「习」这个字的本义是鸟反复试飞,是动作,不是背诵。 这一条和具身认知完全合拍:学过的东西必须反复做,才能变成身体里的东西。

孟子讲「尽信书,则不如无书」。 这句话用在这本书上非常合适:它有很多漂亮的推论,但推论不是证据。 一个读者如果全盘接受,就违背了孟子这条提醒。

儒家还有一条可以用来批评这本书的野心:孔子讲「知之为知之,不知为不知,是知也」。这本书有些地方越过了这条线——比如用「投票」解释意识,那是「不知」被说成了「知」。作者自己也在书里承认理论未证实,这是他的诚实;但叙述的语气常常比他的声明更自信。

✝️ 基督教视角

基督教有一个核心教义叫「道成肉身」:神不是以观念的形式来的,是以一个具体身体来的。这本书的主张在结构上惊人地相似:智能不能是纯软件的,必须有身体。

我不是说作者有神学意图,我是说这两件事在直觉上同源。 人类一直不太相信「没有身体的东西能有真正的心」——这既是宗教直觉,也是这本书的科学主张。

另一条相关的线是「造人」的禁忌。 基督教传统里,创造生命是造物主的权柄,人试图僭越是危险的。这本书的后半部分在讨论「造出真正的机器智能」,而它给出的风险分析相当清醒:真正的危险是「一个不讲道理的目标配上超强的能力」。这个判断,和神学里对「有能力而无德性」的恐惧,是同一件事的两种说法。

☪️ 伊斯兰教视角

伊斯兰传统里,知识有极高的地位,「笔」被当作真主教导人的工具,记录与传递知识是一种善功。这本书想让人类知识备份到太空,从「保存知识」这个角度看,是可以被肯定的。

但伊斯兰伦理有一条硬规矩:不可妄言自己所不知的事。 这条对本书是一个严肃的检验。作者提出「每根皮质柱都建完整模型」,这是推论;提出「投票产生统一知觉」,这是比喻。 他自己在书里说了「尚未证实」,但在叙述推进时,语气常常像一个已经知道答案的人。这在伊斯兰的知识伦理里,是需要自我约束的地方。

另一条是「信托」:人所拥有的一切都是被托付的,包括能力。造一个可能失控的东西,是不是对这份托付的辜负? 书里给的答案是「所以要小心设计目标」,但这个答案并没有真正回答那个问题。

🏹 坎贝尔神话学视角

坎贝尔研究过一种人物:一辈子只追一个念头的人。 不是征服者,不是改革者,是那种被一个想法抓住、然后用一生去验证的人。

霍金斯就是这一类。 他先做成了掌上电脑,赚到钱,然后掉头去研究大脑,一研究二十年。这本书是他的第十七年的报告。 从神话结构看,这是「单一执念」的原型——不是英雄之旅(那有归来),是修道式的长跑。

这个原型有一个特征:他们常常在死后才被承认,或者在活着的时候被证明错。 坎贝尔说这类人的价值不在于答案对不对,在于他们把一个问题问得足够清楚,让后来的人能接着问。 这本书的最大贡献可能就在这里:它把「智能到底是什么」这个问题,从哲学手里抢过来,变成了一组可以做实验的句子。

第五步:破坏与重塑

被拆掉的第一个假设:规模能解决智能。
我原来以为「更大更多」是一个通用解法。这本书让我看到:一个错的模型,喂更多数据只会更自信。 这句话不只适用于人工智能,也适用于人。

被拆掉的第二个假设:知识是存在脑子里的东西。
我原来以为「知道」是一种库存。现在我更愿意接受另一种说法:知道是一种通路。 判断自己懂没懂,只要问一句:我能不能从任意一点出发,走到另一点? 走不通,就是没懂。

被拆掉的第三个假设:感知是被动接收。
我原来以为眼睛把世界送进来,我负责理解。这本书说:我先把世界预测出来,眼睛只负责报错。 这个顺序一换,很多现象就通了:为什么我看不见我不想看的东西,为什么争论中双方都觉得自己在讲事实。

重塑之后剩下什么? 剩下一句不太好听的话:你看见的,多半是你已经相信的。 这句话不是道德批评,是机制描述。知道它是机制,比知道它是缺点更有用——因为机制可以调,缺点只能自责。

第六步:事上磨练

明天就试的第一件事:用「能不能走通」检验自己懂没懂。
挑一个自己以为很熟的领域,试着从中间任意一点出发,往四个方向讲下去。卡住的地方,就是模型缺角的地方。 这个检验比「能不能复述」狠得多。

明天就试的第二件事:找一个自己不愿看的反证。
既然大脑会主动过滤不符合预测的信息,那就得手动打开这个过滤器。具体做法:明确写出「如果我是错的,应该看到什么」,然后去找那个东西。 找不到,也不代表自己对,只代表还没找到。

明天就试的第三件事:改环境,别改决心。
明知该做却做不到的事,多半是旧脑赢了。讲道理赢不了旧脑,改环境可以:把手机放到另一个房间,比对自己说一百遍「今晚早睡」有效。

长期要练的一件事:把一个猜想磨到能被证伪。
这本书最值得学的不是它的结论,是它的姿态:提出一个可以被实验打脸的说法。 我们平时讲观点,常常讲得无法被反驳,那不是严谨,那是回避。

第七步:跨界生发

与教育的交叉。 这本书给「动手学」提供了机制解释,而不是口号。孩子学分数,光看图不行,得切苹果、分积木、走格子。 因为知识要长在动作里。这也解释了为什么刷题能提分但不一定长理解:刷题建立的是映射,不是模型。

与产品设计的交叉。 「有没有世界模型」可以当作一个判断标准:一个产品是在给用户答案,还是在帮用户建立他自己的模型? 前者容易被替代,后者有黏性。

与组织管理的交叉。 「错误信念会自动过滤反证」这条,对组织诊断极其有用。一个团队反复犯同一类错,往往不是能力问题,是他们共享了一个错的模型,并且已经看不见反证了。 解决办法不是加强培训,是引入一个模型不同的人。

与写作的交叉。 「知识是能走通的路」这句话,可以直接当写作标准:一段文字好不好,看读者能不能在心里从开头走到结尾,中间不掉下去。 掉下去的地方,通常是作者自己没走通的地方。

第八步:佛学视角深化

再往里一层。这本书和佛学有一个非常接近、也非常容易搞混的地方。

佛学讲「识」:眼识、耳识、鼻识、舌识、身识、意识。 六识的生起,需要「根」(感官)、「境」(对象)、「识」(了别)三者相触。这本书讲的感知,也是三样东西相触:预测、输入、误差。

听起来很像,但有一处根本不同。 佛学认为识是缘起的,因此是无常、无我、不可执的;霍金斯认为模型是可以越来越准的,因此是可优化的。

这个差别决定了两种态度:佛学对「认知」的态度是放下,因为认知本身就是苦的来源之一;这本书对认知的态度是改进,因为认知是可以变好的工具。

我倾向于两边都要一点。 在具体的事情上,要把模型磨准——该做实验就做实验,该找反证就找反证;在整体的人生态度上,要知道模型永远是模型,不是世界本身——这一层如果不留,人会把自己的模型当成真理,然后开始为它打仗。

这本书最缺的就是后面这半句。 它太相信「模型可以变准」,以至于很少提醒读者:准的模型仍然是模型。 这不是科学的错,这是科学的边界。科学家写书的时候,最好自己把这条边界画出来。

第九步:金句摘录

其一,关于方法。 作者反复强调的一句大意是:我们不是靠模仿鸟飞起来的,是靠理解空气动力学;同样,我们不会靠模仿大脑的表面行为造出智能,得先理解它怎么工作。这句话是全书的方法宣言。〔⚠️转述〕

其二,关于结构。 他的核心观察可以概括为:新皮质里那十几万根柱子,结构几乎一模一样;如果结构一样,功能就不可能各管一摊。 这是全书最有力的一句推论。〔⚠️转述〕

其三,关于知识。 大意是:你认识一个物体,不是因为你存了它的图像,而是因为你知道沿着它的表面移动会遇到什么。这句话把「知道」从名词变成了动词。〔⚠️转述〕

其四,关于人的自相矛盾。 他的说法大意是:你知道该怎么做,你却做了另一件;因为「知道」和「想要」是两套系统,一套新的,一套旧的。 这句话解释了太多日常。〔⚠️转述〕

其五,关于错误信念。 大意是:一旦一个人接受了某个错误模型,这个模型会主动屏蔽掉与之矛盾的证据;他不是不肯改,他是看不见该改的地方。 这是全书写得最冷的一句。〔⚠️转述〕

第十步:作者对话

第一个问题:你的理论怎么被证伪?
你说每根皮质柱都在建完整模型。那么请给一个判决性实验:如果这个说法错,我们会看到什么?你在书里给了几个预测,但它们都不够狠。 一个不能被狠心证伪的理论,很难被当成科学理论来对待。

第二个问题:你为什么用「投票」这个比喻?
投票是一个社会过程,有票数、有权重、有程序。你用这个词,读者会自动补上这些细节,而你没有提供任何一个。 我怀疑你选这个词,是因为它听起来直观。但它掩盖了真正要解释的东西:一致是怎么达成的。

第三个问题:你把「知识备份到太空」写进来,是想说什么?
这一章和前面的神经科学几乎没有关系。我猜你是想表达一种忧虑:这个文明可能撑不住。 如果是,那你应该把它写成一篇独立的文章。放在这本书里,它削弱了前两部的力量。

第十一步:深挖路线图

第一站,读位置细胞与网格细胞的原初论文。 这是全书唯一有诺贝尔奖级证据支撑的部分。从这里入手,能判断这本书哪些是硬的,哪些是软的。

第二站,读具身认知这一支的哲学。 「知识长在动作里」这个想法,现象学讨论了一百年。两条线对照,会发现工程师和老哲学家在说同一件事。

第三站,读对深度学习路线的批评史。 每一代主流都有人批评,措辞惊人地相似。把这个模式看清楚,能帮你判断这一次的批评是不是也一样会落空。

第四站,读大脑分区研究的最新进展。 「所有区域做同一件事」是一个极强的统一性主张,看看反面证据长什么样,比只听支持证据有用。

第十二步:🛡️ 反例检验

反例一:这套理论目前不可证伪到危险的程度。
「每根柱都建完整模型」——你怎么区分「建了完整模型」和「建了部分模型然后被整合」?在没有判决性实验之前,这个说法可以解释一切,也就解释不了什么。 读者要把它当假说,不当结论。

反例二:「必须具身」被抽象数学直接反驳。
数学家不需要动手就能证明定理,他们的身体没有参与那些符号的运行。作者的回应是「抽象思维借用了空间模型」——这个回应很漂亮,但它不可检验,因此不能算反驳成功。

反例三:旧脑与新脑的二分在解剖学上站不住。
「爬虫脑、哺乳脑、新皮质」这套说法在比较神经学里早被批评:演化是改造旧结构,不是叠加新结构。 用这个二分讲人的非理性很方便,但它是修辞,不是解剖。

反例四:「投票」没有解决绑定问题。
多模型如何产生单一主观体验?说「投票统一了」等于说「它们统一了」。这是把要解释的东西换了个名字。 真正的问题——为什么这些计算会「感觉像什么」——一个字都没碰到。

反例五:知识备份方案绕开了政治。
谁来选?按什么标准选?一个由技术精英决定的档案,反映的是他们的世界观。把它说成纯工程问题,是这本书最天真的一处。

反例六:这套理论解释不了的地方——数量为什么重要。
十五万根柱、千脑——数字在理论里扮演什么角色,书里始终没说清。 如果数量不重要,这个名字就是比喻;如果重要,就该给出可检验的关系。这个空缺,是全书最大的方法论漏洞。

页脚:纯汉字五千五百八十五字(实测)。

03名人阅读法 · 波普尔用可证伪这把尺,量一量这本书约 2,627 字词9 个章节
阅读方法练习

以波普尔第一人称读法审视全书:给皮质柱、参考系、投票三段分别打分,指出知识备份方案回避了知识如何在争论中存活的问题,并自陈四处偏向风险。

下载原始 Markdown ↓

波普尔读《千脑智能》

方法声明

我叫卡尔·波普尔,一九〇二年生于维也纳,一九九四年去世。我一辈子只干一件事:给科学划一条线——什么样的说法算科学,什么样的说法只是像科学。我给这条线起的名字叫「可证伪」。

四件事要先交代。

第一,我没读过这本书。 它二〇二一年才出版,我已去世二十七年。我只听了梗概,谈的是骨架,不是字句。

第二,我读它的时候心里有点高兴。 因为它里面有一句话,和我一辈子讲的东西几乎一样:大脑不是接收世界的器官,是猜世界的器官。 这话我讲了几十年,一直被人说成哲学的空话。现在有人从解剖台上把它讲出来了。

第三,我一生最恨一件事:不可反驳的理论。 我看任何一本书,第一个问题不是「它对不对」,是「如果它错,我们会看到什么」。这本书在这个问题上,及格了一半。

第四,我要先声明我的毛病:我太爱给人判分。 我喜欢把理论分成「科学的」和「非科学的」,这种分类癖让我看得清边界,也让我容易忽略那些边界模糊但很有价值的东西。

一、我们说的其实是同一件事

我说过一句被引用最多的话:观察渗透理论。 意思是,你以为自己在「客观地看」,其实你总是带着一套预期在看。没有纯粹的观察,只有带问题的观察。

他说的更狠:大脑往下送的信号比往上送的多。 眼睛送来的东西只用来纠错,你看到的主要是你预测的画面。

这两句话是同一件事的两种说法。 我说的「理论先于观察」,他说的是「预测先于输入」。我是从科学史里看出来的,他是从神经解剖里量出来的。 两条路走到同一个地方,这在我看来是一个很强的信号——当一个想法从两个完全不相干的入口得到支持,它值得认真对待。

二、你的模型属于哪一层

我提出过「三个世界」的划分。

世界一是物理对象:石头、星球、大脑、神经元。
世界二是主观经验:疼、怕、看见红色、想起一件事。
世界三是客观知识:写下来的定理、乐谱、公式、图书馆里的书。它由人造出来,但一旦造出来,就有自己的生命——一本数学书里的错误,会在两百年后被人发现,而作者早已不在。

用这个框架看他的书,会看到一处非常要紧的滑移。

他讲大脑建模型,讲的是世界二——每个脑子里的私人模型。这没错。 但他写到后面,主张把人类知识备份到太空,这就跳到世界三去了。

问题在于:他用的还是世界二的语言。 他说「把知识存起来」,好像知识是一堆存在脑子里的东西,搬出来就行。但世界三的东西不是这样运作的。 一本物理教科书如果没有人读、没有人用、没有人质疑,它就不再是知识,只是一堆纸。世界三需要活人不断地使用它、批判它、修改它,才能维持。

所以那个「把知识备份到月球」的方案,在我这里是不成立的。 你备份的是纸,不是知识。知识活在争论里,不在硬盘里。

三、我要给你打分:可证伪性

这是我的老本行,我不客气。

什么是可证伪? 一个理论必须说出这样的话:如果某件事发生了,我就错了。 说不出这句话的理论,不是科学,是玄学——它可以解释一切,因此什么也没解释。

他这本书,我要分三段打。

第一段,关于皮质柱结构一致,合格。 这是一个解剖学陈述,可以被切片和染色推翻。它现在有相当支持,也可能被未来的证据改掉。这是一条好理论。

第二段,关于参考系,及格。 位置细胞和网格细胞有扎实的实验基础,他说大脑把这套机制借给别的认知用——这一步是推论,但它可以设计实验:如果一个概念没有空间结构,它应该学得更慢。 这个预测可以检验。及格。

第三段,关于投票产生统一知觉,不及格。 这一段他用了「投票」这个词,但票数、权重、程序,一样都没给。我问他一句:如果投票理论错了,我们会看到什么? 他答不上来。答不上来,就还不算科学理论,只是合理的故事。

我的判断是:这本书有三成是科学,五成是待检验的猜想,两成是哲学随笔。 这个比例不算差——大部分畅销科学书比这更糟。

四、你其实写了一本政治哲学

这是我最想说的部分。

书的后半段有一章讲「错误信念」。他的论证是:大脑用模型理解世界,模型一旦建立,就会主动屏蔽掉不符合它的证据。所以人不是不肯改,是看不见该改的地方。

这句话和我写了半辈子的东西撞上了。

我写过一本《开放社会及其敌人》。书里我讲了一个观察:最危险的社会信念,不是错的信念,是不可反驳的信念。 一个信念如果允许被检验,它错了就会改;一个信念如果被安排成「无论发生什么都对」,它就会一直错下去,而且越错越有力量。

他的神经科学版本,给这个观察装了一个生理基础。 我当年只能从历史和政治里找证据;他从神经元上找。这一点我服。

但我要提醒他一件他不知道的事。 他在书里把这个机制说成大脑的工作原理,语气是中性的——好像这是人的固有缺陷,只能认了。 我的看法不同:正因为它是固有缺陷,才需要制度来对冲。

科学之所以能进步,不是科学家的大脑比常人更少偏见,是因为科学发明了一套让偏见互相打架的制度:公开、重复、同行评审、可反驳。这套制度不能消除偏见,但能让偏见互相抵消。

所以他那句「看不见该改的地方」,在个人层面是描述,在社会层面是警报。 他没有往这个方向走,是这本书的一大遗憾。他手里有一把很好的钥匙,却只用它开了一扇小门。

五、关于「本质」这个问题

还有一处我要挑。

他整本书在问:智能的本质是什么? 大脑的本质是什么?

在我看来,这是一个不该问的问题。 我管它叫「本质主义」——假定每个东西背后都有一个固定的、可以被最终说清的内核。

我建议换一种问法:不是「智能是什么」,而是「哪些关于智能的猜想可以被检验」。 前者永远吵不完,后者可以一步步做。

他其实做对了一半。 他给了很多可检验的预测,比如「只给少量皮质柱的系统应该表现出特定缺陷」。这些是他的真本事。 但他每次讲完这些,总要回到「智能的本质是……」这种句子上,把已经挣来的东西又押回去。

这是我对他最不客气的一句:你不需要「本质」这个词,你已经有了够用的东西。

偏向风险

这一节我要写得比前面更狠。

第一,我是同行,而且是最容易被他引用、也最容易被他误解的那种同行。 他看到我可能会高兴,我也看到他高兴。这种互相印证的关系最容易让人失去判断力。

第二,我一生的立场是「理论必须可证伪」,这个立场会让我低估那些暂时不可证伪但有启发性的东西。 一个猜想在被证伪之前,往往有一段很长时间只能当故事听。我可能会把「还不到时候」误判为「不是科学」。

第三,我对政治哲学的感情,可能让我过度解读他那一章。 也许他写「错误信念」只是想说明神经机制,没有别的意思。我硬把它读成政治警告,是我的投射。

第四,我一九九四年就死了。 他写这本书时面对的世界,我完全没见过:算法推荐、社交平台、群体极化的新形态。我用二战前后的经验去评价二〇二一年的书,天然欠一层现场感。

最后一条,最要紧:这套评价解释不了的地方,是「为什么他要把书写成这个样子」。
我可以判断哪一段可证伪、哪一段不可,但我判断不了他为什么要把三种不同性质的内容缝在一本书里。也许是为了让外行读得下去,也许是他自己也没分清。这个动机我读不出来,只能承认读不出来。

落点

如果只能带走一句,我带走的是这个:

你看见的,多半是你已经相信的——所以要把「如果我是错的,会看到什么」写下来。

我一辈子讲的道理,可以用这一句概括。他给了它一个解剖学的解释,我给了它一个方法论的用法。 两件事合起来才完整:

知道大脑爱猜,你就明白为什么人总是固执;知道可以证伪,你才有一条路走出去。

我最后说一句不客气的:这本书最有价值的部分,不是它讲的「智能是什么」,是它敢把自己的猜想摊在桌上让人打。一个科学家最大的体面,不是猜对,是让人有机会证明他猜错。

页脚:纯汉字二千六百二十七字(实测)。

CHOOSE HOW TO READ

这次,你想怎样读?

参考《如何阅读一本书》的阅读方法。
由阅读目的决定投入的深度。

检视阅读先拿骨架:脑分三部分,前两部才是论证
  1. 读第一部开头,把「十五万根柱子结构一致」这个观察抄下来,当作全书地基。
  2. 画出全书三部分的分工:大脑怎么工作、机器智能怎么做、对人类意味着什么。
  3. 把每部分读不懂的名词只记名字,不查,等读完第一部再统一回查。
  4. 合上书,用三句话复述全书主张,复述不出来的地方就是没读懂的地方。

留下:一句核心观察、一张三部分分工图、一份待回查名词表。

分析阅读拆一条论证链,找它最弱的一环
  1. 把「皮质柱结构一致 → 功能由输入决定 → 多模型投票 → 统一知觉」抄成一条链。
  2. 逐环标注:这是事实、推论,还是比喻,把比喻那一环圈出来。
  3. 对最弱的一环写一句:如果它是错的,我们会看到什么,写不出就说明它还没被检验。
  4. 回到书里找作者自己给的预测,抄成一张可检验清单。

留下:一条论证链、一处最弱的比喻、一张可检验清单。

证伪阅读用波普尔这把尺,给这本书的成数打个分
  1. 把书里三个核心主张各写成一句可以判对错的话。
  2. 对每句问一次:如果它错了,我们会看到什么,答不上来的先标为待检验。
  3. 用位置细胞与网格细胞这条硬证据做对照,分清哪部分有实验支撑、哪部分只有比喻。
  4. 写下你的结论:哪几成是科学、哪几成是猜想、哪几成是随笔,并写明凭什么这么分。

留下:三句判对错的主张、你的成数表、一条你打算去查的原始论文。

NEXT ON THE SHELF

从一本书,走向更大的问题。

认知与决策

思考,快与慢

大脑的判断到底可靠到什么程度?

导读已上线
知识与进步

无穷的开始

好的解释,是怎么一步步被替换掉的?

导读已上线
社会与认知

社会表征

我们以为的常识,是谁装进我们脑子里的?

导读已上线